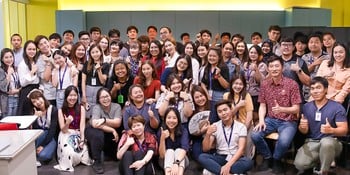
งาน LINE THAILAND DEVELOPER CONFERENCE 2026 ภายใต้ธีม Build the Next Frontier จัดขึ้นเมื่อวันเสาร์ที่ 17 ตุลาคม 2026 ที่ไบเทค บางนา มีการเล่าเรื่องถึงการนำ Agentic AI มาเติมความรู้ให้นักพัฒนา และผู้สนใจในเรื่องดังกล่าวจนสามารถนำไปต่อยอดในอาชีพ และสร้างโอกาสธุรกิจใหม่ได้อย่างมีประสิทธิภาพ
แต่ที่มากกว่าแค่ข้อมูลภาพรวม Agentic AI และการประยุกต์ใช้ ภายในงานยังมีแทร็ก Deep Tech ที่เจาะลึกเนื้อหาการนำ Agentic AI ไปใช้อย่างเข้มข้น ผ่านผู้เชี่ยวชาญ และกรณีศึกษาที่ใช้กับระบบจริง ซึ่งเป็นแทร็กพลาดไม่ได้สำหรับคนทำงานสายเทคนิค เพราะหัวข้อทั้งหมดไม่ได้พูดถึงแค่ AI เขียนโค้ดให้เร็วขึ้นแค่ไหน? แต่พูดถึงคำถามที่ลึกกว่านั้น
เพราะเมื่อ AI Agent เขียนโค้ดได้เร็วและเยอะขึ้น ทีมวิศวกรต้องปรับโครงสร้าง, กระบวนการ และโครงสร้างพื้นฐานอย่างไรเพื่อรองรับความเร็วนั้นได้อย่างปลอดภัย พูดง่าย ๆ คือการเปลี่ยนจาก การเขียนโค้ด ไปสู่การสร้าง Guardrails, Governance และ Infrastructure ที่แข็งแกร่ง สำหรับ AI Agent ซึ่งใครที่ไม่ได้ร่วมงาน หรือพลาดเนื้อหาจากแทร็กนี้ไป Blognone ได้สรุปเนื้อหาไว้ให้ดังนี้
เมื่อ AI เขียนโค้ดเร็วขึ้น แต่ทีมตามไม่ทันแล้วจะแก้ไขอย่างไร
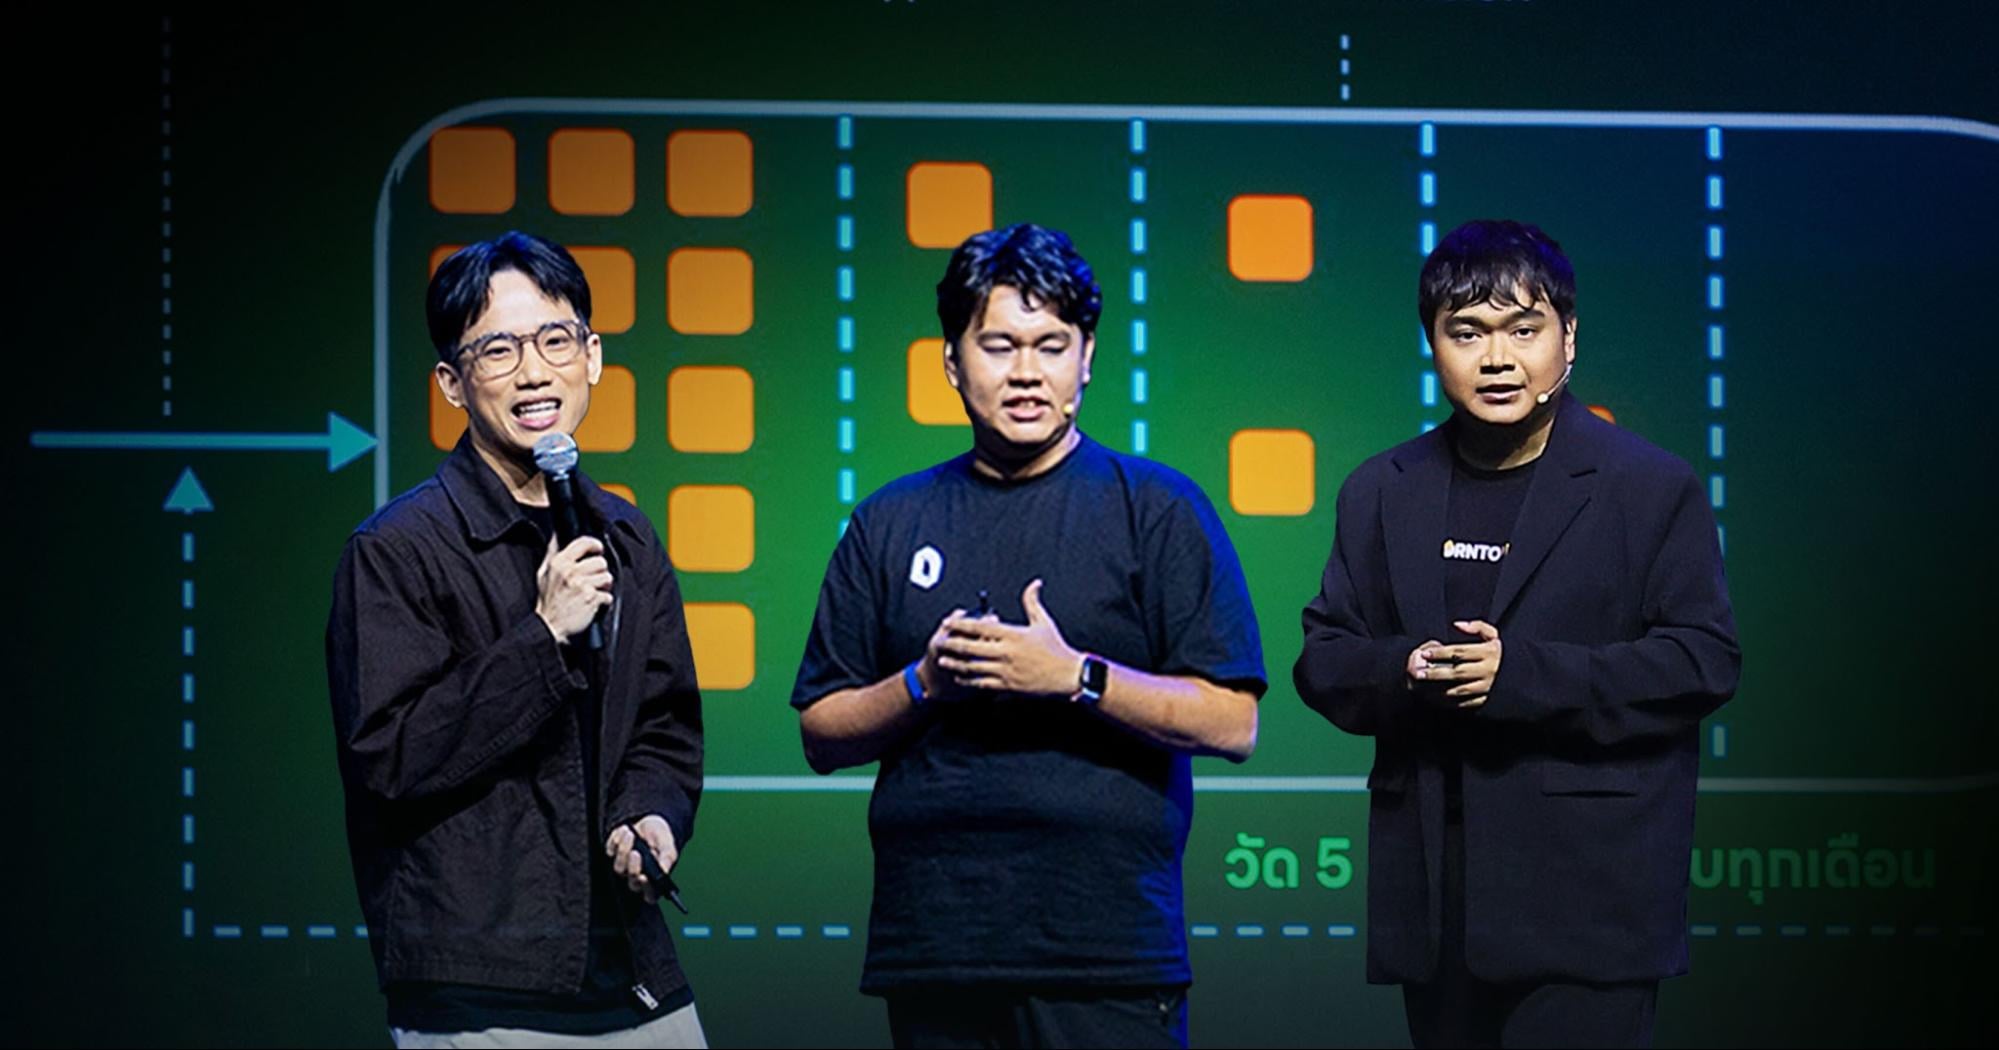
หัวข้อแรกของแทร็ก Deep Tech เริ่มต้นกับ กิตติกร ประเสริฐศักดิ์ หรือแอดเปรม ผู้ก่อตั้ง และกรรมการผู้จัดการ BorntoDev ที่มาเจาะลึกของปัญหาทีมนักพัฒนาขนาดเล็ก หรือไม่เกิน 15 คน ที่นำ AI Agent มาใช้งาน แต่กลับติดปัญหา Bottleneck Paradox นั่นคือ AI Agent สามารถเขียนโค้ดและเปิด Pull Request (PR) ได้เร็วมาก จนทำให้ทีมมี PR ที่รอการรีวิวเพิ่มขึ้นถึงกว่า 441.5%
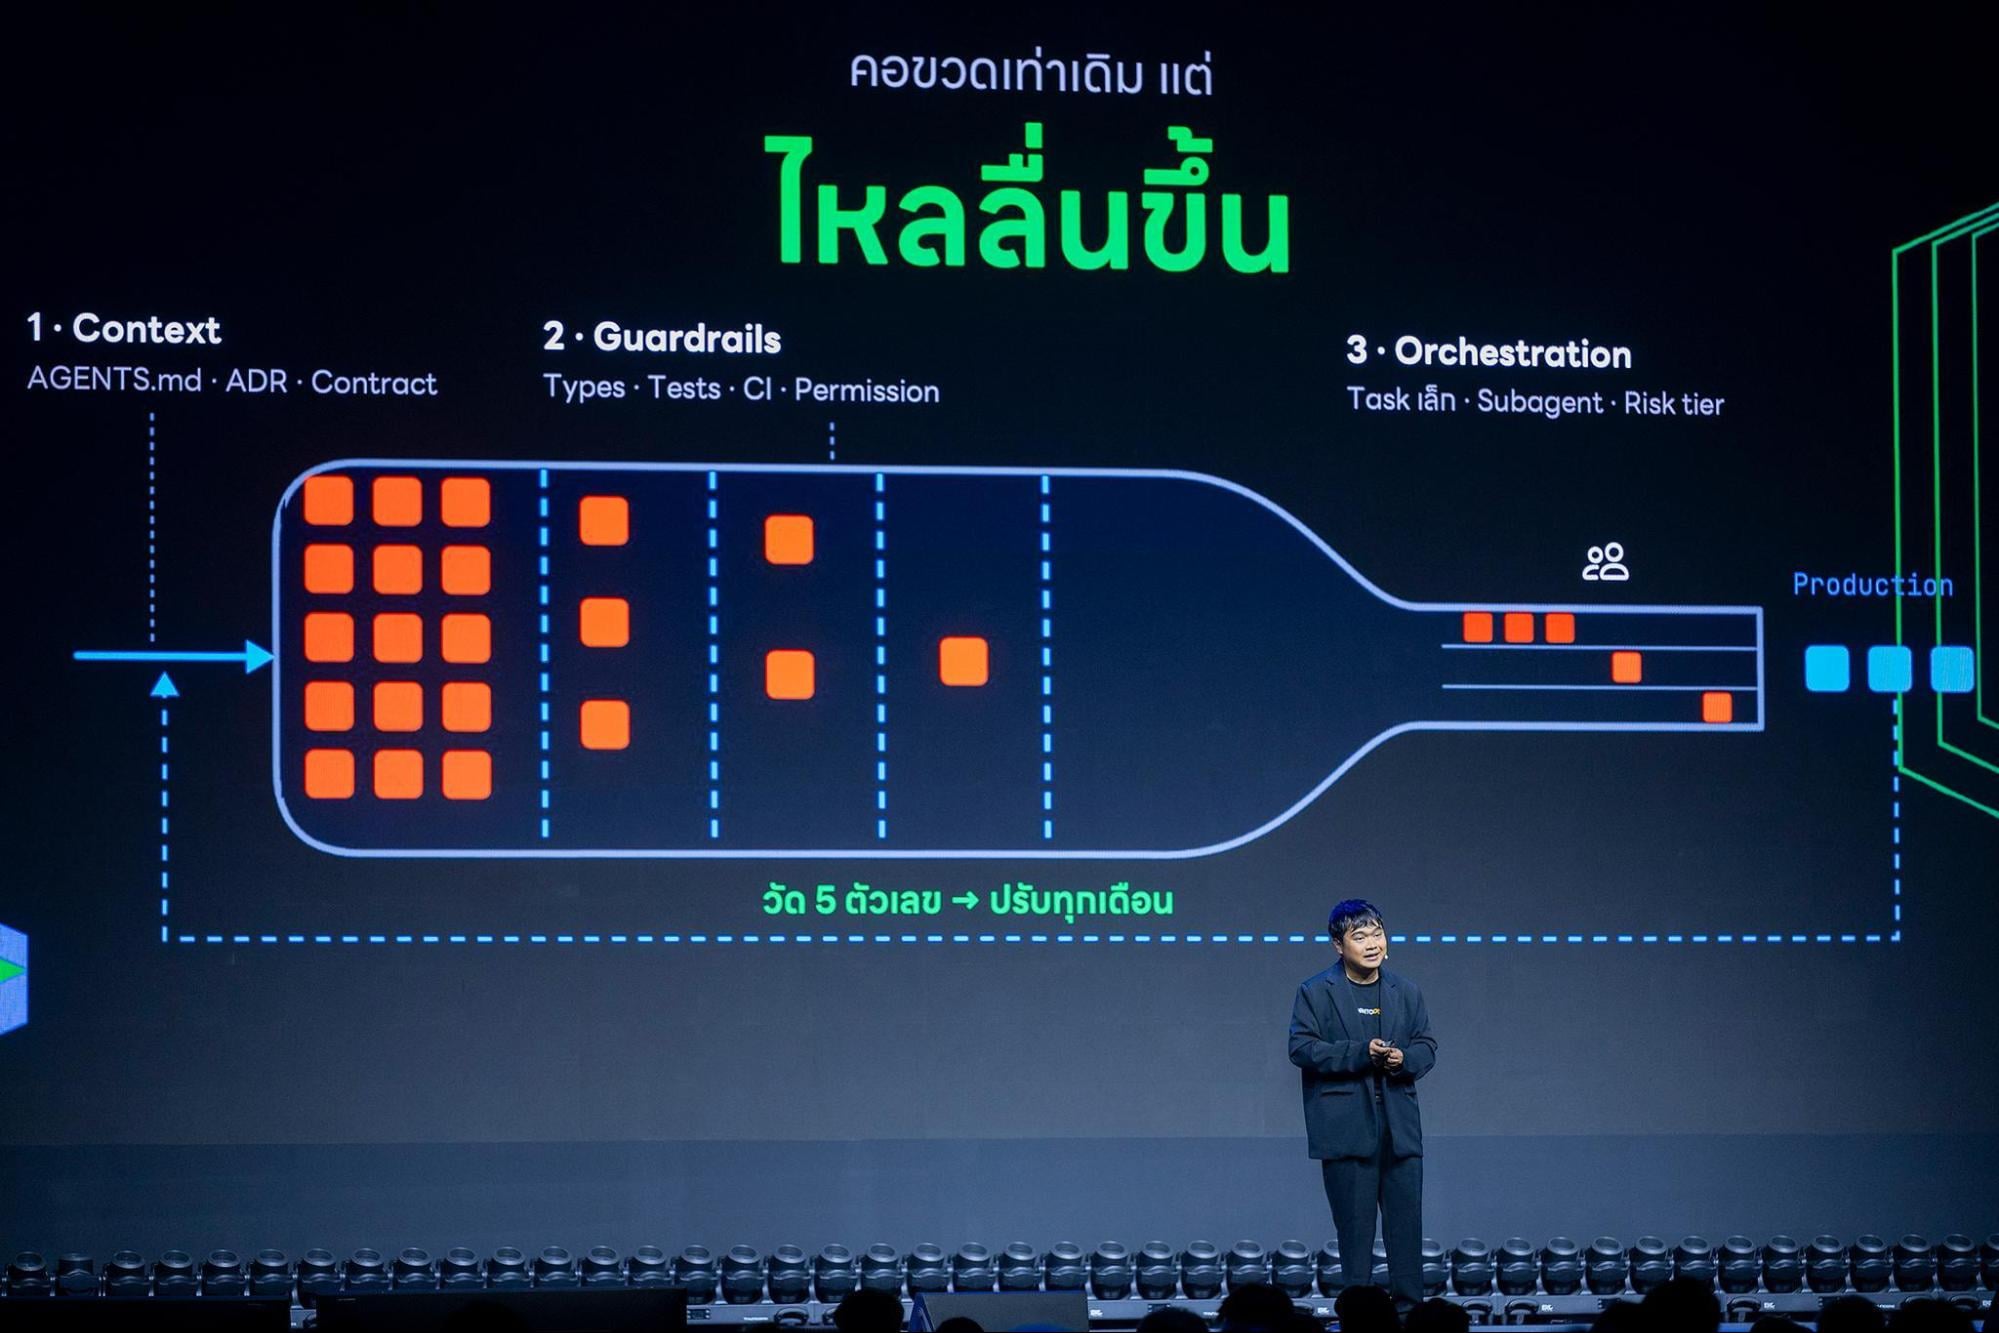
สิ่งที่น่ากลัวกว่านั้นคือ AI ทำหน้าที่เป็น ตัวคูณ หากกระบวนการทำงานหรือข้อกำหนดเดิมของทีมไม่ชัดเจนอยู่แล้ว AI จะยิ่งขยายความผิดพลาดหรือคุณภาพที่ไม่ดีให้มากขึ้นตามไปด้วย และเนื่องจากความต้องการทางธุรกิจไม่สามารถลดลงได้ง่าย ๆ ทางออกจึงต้องอยู่ที่การปรับกระบวนการพัฒนาเอง ซึ่งบางทีมกว่าจะเจอก็เผชิญกับต้นทุนที่เพิ่มขึ้นไปแล้ว
แอดเปรม จึงเสนอกรอบการแก้ปัญหาดังกล่าวเป็น 3 มิติ ดังนี้
- มิติแรกคือ Context Engineering หรือการจัดการข้อมูลนำเข้าให้ AI Agent ทำงานได้แม่นยำ โดยใช้ไฟล์สั้น ๆ อย่าง AGENTS.md กำหนดขอบเขตความรับผิดชอบและคำสั่งเฉพาะของแต่ละ Agent แทนการยัดเอกสารทั้งหมดให้อ่าน พร้อมทั้งใช้ Architecture Decision Record (ADR) บันทึกเหตุผลเบื้องหลังการตัดสินใจ เช่น ทำไมถึงตัดตัวแปรหนึ่งออก เพื่อให้ผู้รีวิวตรวจสอบง่ายขึ้น แทนที่จะต้องไล่อ่านโค้ดทั้งหมด
- มิติที่สองคือ Guardrails หรือการป้องกันความเสี่ยง โดยแทนที่จะพึ่งพาการสั่งงานด้วย Prompt ให้ฝังกฎเข้าไปใน Workflow ของโปรเจกต์โดยตรง ควบคู่กับการตรวจสอบการตั้งชื่อตัวแปร รัน Type Check และยืนยันว่าโค้ดตรงตามข้อกำหนดก่อนถึงมือมนุษย์ รวมถึงหลีกเลี่ยงการให้สิทธิ์ Root หรือข้ามการตรวจสอบสิทธิ์ให้ AI โดยแนะนำให้แยกบัญชีสำหรับงานของ AI ออกต่างหากเพื่อลดความเสี่ยง
- มิติที่สามคือ Workflow & Orchestration หรือการจัดการกระบวนการรีวิว ด้วยแนวทาง Red-Green-Refactor ให้ AI เขียนเทสต์ก่อนตามความต้องการทางธุรกิจ แล้วให้มนุษย์รีวิวเทสต์เหล่านั้นก่อนว่าตรงเป้าหมายหรือไม่ ก่อนให้ AI ลงมือเขียนโค้ดจริง นอกจากนี้ยังแบ่งระดับความเสี่ยงของงานเป็น
- Tier 0 งานเล็กความเสี่ยงต่ำ ให้ AI ทำพร้อมตรวจอัตโนมัติ
- Tier 1 งานทั่วไปที่ให้ Developer ตรวจสอบ
- Tier 2 งานความเสี่ยงสูง เช่น Payment และ Authentication ซึ่งต้องให้ Senior Developer หรือผู้เชี่ยวชาญตรวจสอบ
Fastwork กับการวาง AI Infrastructure ในองค์กรขนาดกลาง
มากันต่อที่กรณีศึกษาของ Fastwork ที่เล่าโดย ขจรศักดิ์ พีรพัฒนานนท์ Engineering Partner ของ Fastwork เพราะปัจจุบัน Fastwork เป็นองค์กรขนาดราว 100 คน มีวิศวกร 30 คน และเจอกับปัญหาการนำ AI มาใช้ในองค์กรมากมาย ไม่ว่าจะเป็นการจัดการ API Key ที่กระจัดกระจาย การติดตามการใช้งานและค่าใช้จ่ายที่อาจพุ่งขึ้นแบบไม่ทันตั้งตัว ความเร็วในการอัปเดตโมเดลใหม่ ๆ และการชั่งน้ำหนักระหว่างความปลอดภัย กับการกำกับดูแล กับวิสัยทัศน์ Move Fast ขององค์กร
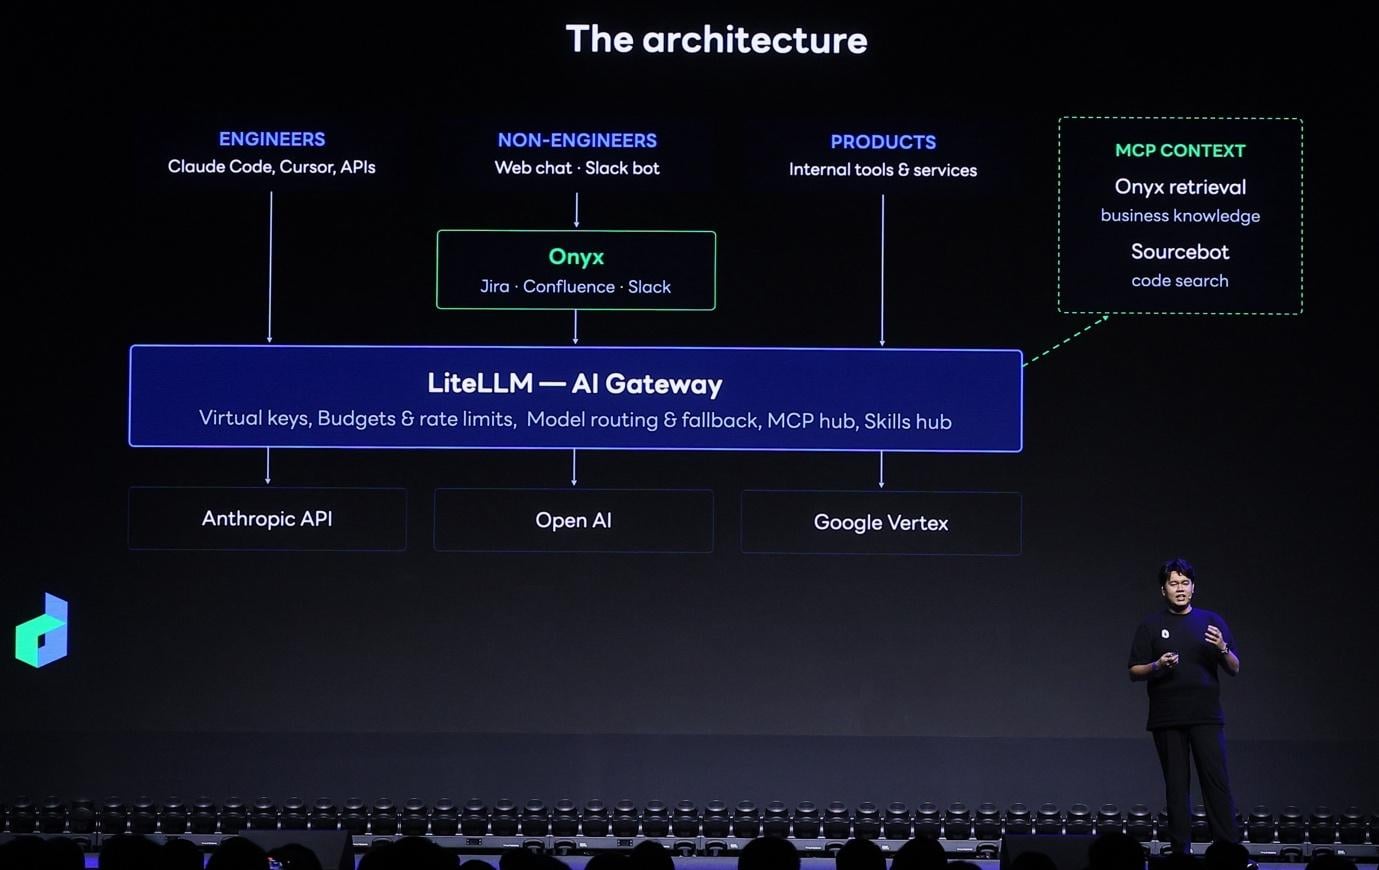
จุดที่น่าสนใจคือ Fastwork มองผู้ใช้งาน AI ภายในองค์กรเป็น 4 กลุ่มที่มีความต้องการต่างกันชัดเจน คือ
- วิศวกร: ผู้ต้องการโค้ดที่เข้าใจบริบท
- ผู้ที่ไม่ใช่สายเทคนิค: ใช้งานแค่การถาม-ตอบจากฐานความรู้ภายใน
- ทีมโปรดักต์: ทีมที่ต้องผนวก AI เข้าไปในผลิตภัณฑ์พร้อมควบคุมต้นทุนและการกำกับดูแล
- ฝ่ายบริหาร: กลุ่มที่ต้องการความโปร่งใสเพื่อวางแผนงบประมาณ
การแบ่งออกมาเป็น 4 กลุ่มทำให้เกิดหลักการออกแบบ รวมศูนย์การกำกับดูแล แต่กระจายประสบการณ์ใช้งานให้เหมาะกับแต่ละกลุ่ม
ในเชิงสถาปัตยกรรม Fastwork เลือกใช้ LiteLLM เป็น AI Gateway รวมศูนย์คำขอ API ทั้งหมด ทำให้มี endpoint เดียว จัดการคีย์ กำหนดงบประมาณและลิมิต Token ได้ รองรับผู้ให้บริการหลากหลายทั้ง OpenAI, Anthropic, Gemini ผ่าน SDK เดียวกัน ด้านการตรวจสอบย้อนหลังใช้ Langfuse เก็บข้อมูลต้นทุน Token และเวอร์ชันของ Prompt
ส่วนการจัดการบริบทการใช้งานจะแยกออกเป็นสองฝั่งชัดเจน เริ่มที่ Sourcebot สำหรับทีมวิศวกรใช้ค้นหาและจัดทำการบันทึกโค้ดเพื่อป้อนให้ AI Agent และ Onyx สำหรับจัดทำดัชนีเอกสารภายในอย่าง Jira, Slack, Confluence ให้บริการถาม-ตอบพร้อมอ้างอิงต่าง ๆ ซึ่งทั้งหมดอยู่ภายใต้แนวคิดการประกอบซอฟต์แวร์โอเพนซอร์สที่มีอยู่แล้วเข้าด้วยกัน แทนที่จะสร้างใหม่จากศูนย์
Mikelopster กับเทคนิคสอนให้ Agent ทำงานแทนทีม
อีกช่วง Deep Tech ที่น่าสนใจคือ เทคนิคสอนให้ Agent ทำงานแทนทีม โดย ธนิศร์พนธ์ ปาณิวรรณ CTO ของ Apppi และเจ้าของช่อง Mikelopster เล่าให้ฟังว่า โจทย์หลักหลังจากนี้คือการลด Agent Loop หรือเวลาที่ Agent ใช้ในการประมวลผล และลดรอบการรีวิวของมนุษย์ ไปพร้อม ๆ กัน โดยไม่พึ่งพาคนตรวจสอบมากเกินไปจนเสียเวลา
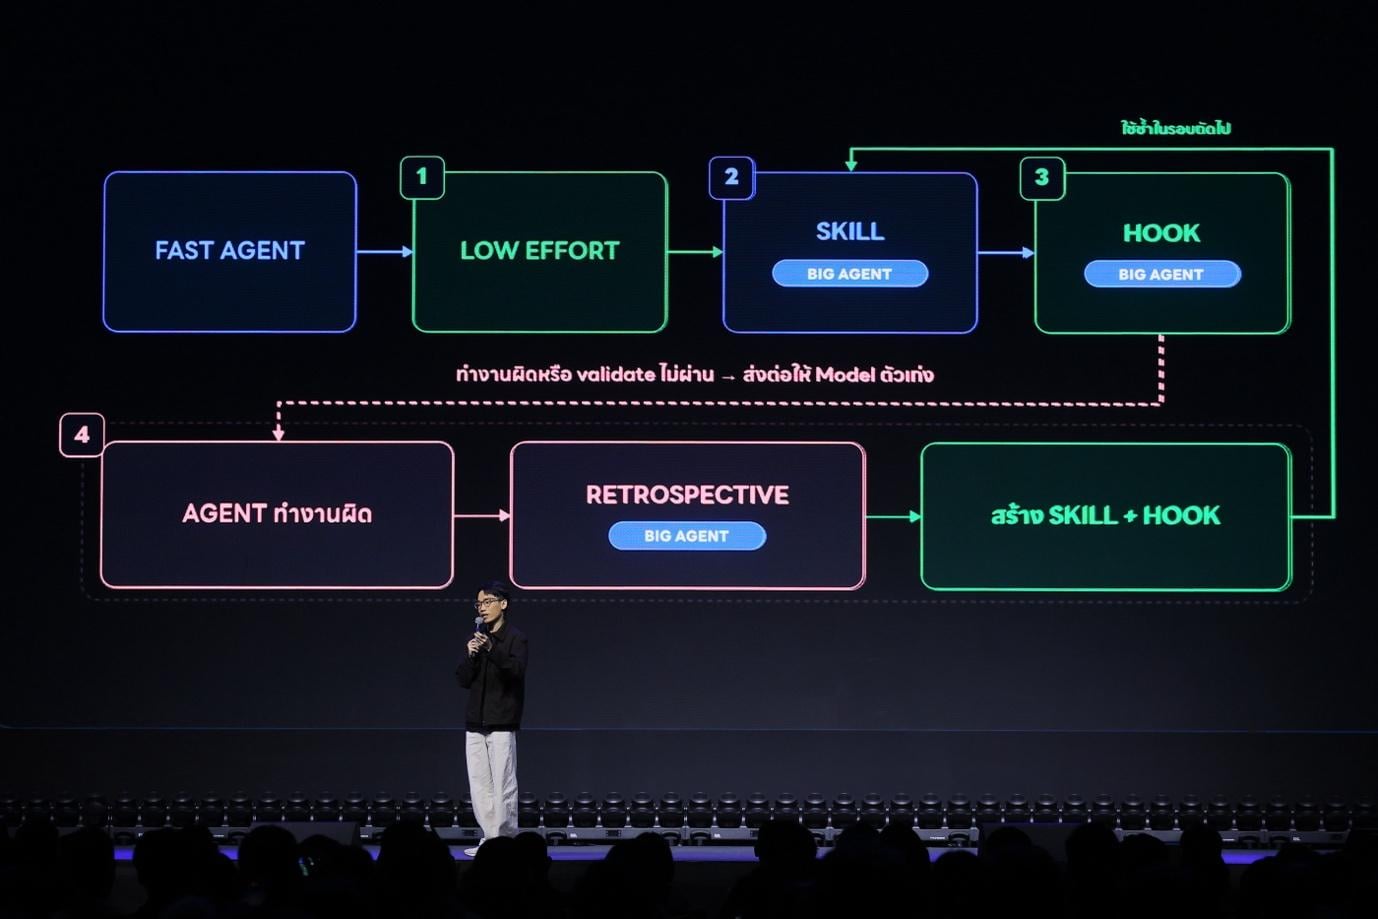
แนวคิดสำคัญคือการแลกเปลี่ยนระหว่าง Low Effort กับ High Effort หรือการลดจำนวนรอบที่โมเดลต้องวนหาคำตอบช่วยให้ Agent ทำงานเร็วขึ้น แต่ก็มักต้องการการรีวิวของมนุษย์เพิ่มขึ้นหากไม่มีการจัดการที่ดีพอ โดยเทคนิคที่น่าสนใจคือการใช้ Knowledge Distillation หรือดึงความน่าจะเป็นจากโมเดลขนาดใหญ่ที่มีความสามารถสูง เช่น Claude Opus มาช่วยกำกับหรือปรับจูนโมเดลขนาดเล็กที่เร็วกว่าอย่าง Gemini Flash ผ่านการกำหนด Skill Set ที่ชัดเจนและการใช้ Hook หรือการแทรกสคริปต์กับการตรวจในขั้นตอนต่าง ๆ
การวางกรอบแบบนี้จะคล้ายกับให้ Senior Developer คอยกำกับ Junior ให้ทำงานถูกทาง ยิ่งโมเดลขนาดเล็กอย่าง Gemini Flash มีค่า TPS (Tokens Per Second) สูงกว่าโมเดลขนาดใหญ่ ทำให้เหมาะกับงานบางประเภทหากถูกสั่งงานอย่างถูกต้อง นอกจากนี้ ยังมีการใช้โมเดลเฉพาะทางสำหรับตัดสินใจ หรือ Decision Model เช่น Jev เพื่อประเมินอย่างรวดเร็วว่าผลลัพธ์ของ Agent ตรงตามเกณฑ์ที่กำหนดไว้หรือไม่ แทนที่จะพึ่งพาการรีวิวด้วยมือทั้งหมด
ในส่วนของปัญหาที่พบบ่อย วิทยากรพูดถึง Prompt Soup หรือ Prompt ที่คลุมเครือจนทำให้ Agent หลงทางหรือสร้างฟีเจอร์ที่ไม่จำเป็น และ Skill Hell ที่หมายถึงผลเสียจากการมี Skill ที่ซ้ำซ้อนมากเกินไปจนทำให้ Agent สับสน รวมถึงปัญหาความไม่มีประสิทธิภาพในการค้นหา ซึ่ง Mikelopster แนะนำให้ใช้เครื่องมืออย่าง Graphify เพื่อสร้างแผนที่ความสัมพันธ์ของโค้ดช่วยนำทางการค้นหาให้แม่นยำ
สุดท้าย Mikelopster ย้ำว่า Agent ขนาดเล็กจะมีประสิทธิภาพสูงสำหรับงานเฉพาะทาง แต่โมเดลขนาดใหญ่ยังจำเป็นสำหรับกรณีการใช้งานในบริบทที่ Agent ไม่เคยพบมาก่อน ดังนั้นประโยชน์ที่แท้จริงจึงอยู่ที่การออกแบบ Process และ Workflow ที่ดีผ่านเทมเพลต สเปก และ Hook มากกว่าการยึดติดกับโมเดลใดโมเดลหนึ่ง
แม้ทั้งสามหัวข้อจะมาจากบริบทต่างกัน ตั้งแต่ทีมเล็ก องค์กรระดับกลาง ไปจนถึงการออกแบบ Agent เฉพาะทาง แต่สิ่งที่พบเหมือนกันคือ ทุกองค์กรกำลังเผชิญคำถามเดียวกันว่า เมื่อ AI Agent เขียนโค้ดได้เร็วขึ้นเรื่อย ๆ จะทำอย่างไรให้ความเร็วนั้นไม่กลายเป็นความเสี่ยง คำตอบที่ทั้งสามหัวข้อชี้ไปทางเดียวกันคือการลงทุนสร้างโครงสร้างที่แข็งแกร่ง ไม่ว่าจะเป็นกระบวนการรีวิว ระบบกำกับดูแล หรือโครงสร้างพื้นฐานที่รองรับ Agent โดยเฉพาะ แทนที่จะมองว่า AI เป็นเพียงเครื่องมือเขียนโค้ดเร็ว ๆ
นี่คือสาระสำคัญของแทร็ก Deep Tech ในงาน LINE THAILAND DEVELOPER CONFERENCE 2026 ที่สะท้อนให้เห็นว่าวงการพัฒนาซอฟต์แวร์ไทยกำลังก้าวข้ามคำถามว่า จะใช้ AI เขียนโค้ดอย่างไร ไปสู่คำถามที่ลึกกว่าว่า จะออกแบบ Ecosystem ให้ AI Agent ทำงานร่วมกับทีมได้อย่างปลอดภัยและยั่งยืนอย่างไร