 on
แนวทางการใช้งาน AI ในกลุ่ม LLM ในช่วงหลัง นอกจากการใช้แบบ agentic ช่วยเขียนโค้ดหรือทำงานแทน อีกด้านหนึ่งคือการนำเอกสารภายในองค์กรที่เป็นความรู้เฉพาะมาให้ AI อ่านและตีความเพื่อให้ AI สามารถทำงานเฉพาะทาง เช่น กระบวนการเฉพาะของบริษัท ตลอดจนข้อมูลในองค์กรที่เดิมอาจจะเก็บในรูปแบบที่สืบค้นได้ยากและมักเป็นไฟล์รูปภาพหรือ PDF ที่แปลงเป็นข้อความโดยตรงไม่ได้
ข้อจำกัดเหล่านี้ทำให้ความนิยมในการแปลงเอกสารเป็นข้อความสูงขึ้นมาก เนื่องจากที่ผ่านมา AI มักอ่านข้อความเป็นหลัก การเก็บเอกสารเป็นข้อความทำให้เราสามารถค้นหาที่มาของความรู้ต่างๆ ได้โดยง่าย ในโลก AI เราเห็นโครงการจำนวนมากพยายามนำเสนอแนวทางการแปลงภาพเป็นข้อความ เช่น Docling ของ IBM, LlamaIndex, Unstructured ตัว LlamaIndex ที่เป็นหนึ่งในโครงการที่ได้รับความนิยมอย่างสูง แม้ในช่วงหลังบริษัทจะหันไปเน้นบริการ LlamaParse ที่เป็นคลาวด์ แต่ก็ยังคงพัฒนาตัวเฟรมเวิร์ค LlamaIndex พร้อมกับโอเพนซอร์สโครงการ LiteParse ออกมาและพัฒนาต่อเนื่อง
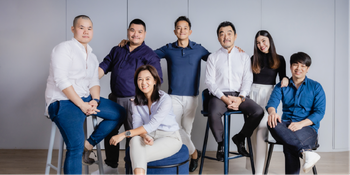
ผมได้มีโอกาสพูดคุยกับคุณณัชพล เด่นดำรงทรัพย์ หนึ่งในทีมงาน LlamaIndex (จบการศึกษาระดับปริญญาโทจาก Stanford และอดีตหัวหน้าทีม Machine Learning Engineer ที่ Onclusive) ถึงประเด็นความสำคัญของการนำเอกสารภายในองค์กรมาประมวลผลร่วมกับ AI
บทสนทนานี้น่าจะช่วยฉายภาพให้เห็นทิศทางการใช้งานข้อมูลเอกสาร ซึ่งยังคงทวีความสำคัญขึ้นเรื่อยๆ แม้ในช่วงหลังโมเดล AI จะเริ่มมี context window ขนาดยักษ์ที่รองรับการอ่านเอกสารได้พร้อมกันนับพันหน้าแล้วก็ตาม
LlamaIndex ทำธุรกิจอะไร และคู่แข่งคือใคร
LlamaIndex ทำ AI document processing ตั้งแต่การอ่านเอกสาร (parsing) ไปจนถึงการดึงข้อมูลออกจากเอกสาร (extraction) ครับ LlamaParse แปลงเอกสารให้อยู่ในรูปแบบที่เครื่องอ่านได้ด้วยต้นทุนต่ำและความแม่นยำสูง ส่วน LlamaExtract ดึงข้อมูลออกมาตามโครงสร้างที่ลูกค้ากำหนด ข้อมูลเหล่านี้จะถูกประมวลผลให้อยู่ในรูปแบบที่ระบบ AI ปลายน้ำนำไปใช้งานต่อได้อย่างมีประสิทธิภาพ ซึ่ง RAG (Retrieval-Augmented Generation - กระบวนการค้นข้อมูลประกอบให้ AI ก่อนที่จะตอบคำถามผู้ใช้) เป็นหนึ่งในการใช้งานหลัก ขั้นตอนนี้มีผลต่อทั้งระบบ เพราะถ้าอ่านเอกสารผิดตั้งแต่ต้นคำตอบก็อาจผิดตามไปด้วย เรามีระบบที่รองรับไฟล์หลากหลายประเภท ไม่ว่าจะเป็น PDF, Microsoft Word, Excel และอื่น ๆ อีกมากมาย สิ่งสำคัญคือ attribution ทุกค่าที่เราดึงออกมาอ้างอิงกลับไปยังเอกสารต้นฉบับได้ เวลามีคนตรวจสอบว่าตัวเลขนี้มาจากไหน ก็เปิดดูหน้าที่เป็นแหล่งข้อมูลได้ เรื่องนี้จำเป็นสำหรับอุตสาหกรรมที่มีข้อกำหนดด้านการตรวจสอบ
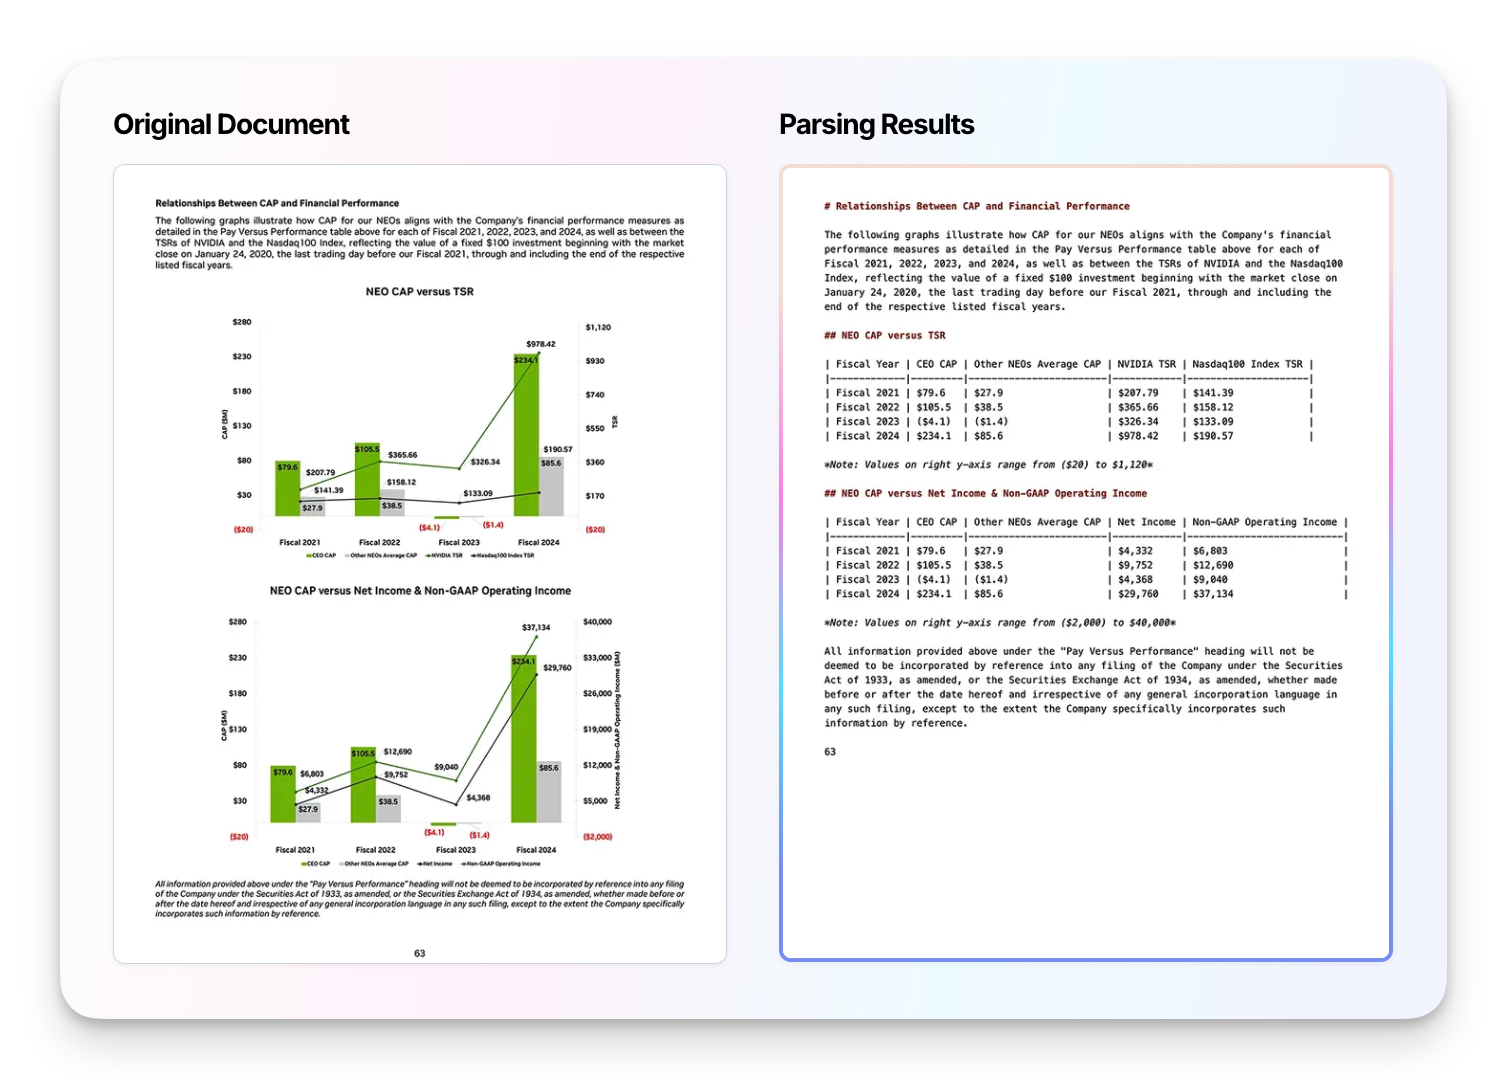
งานที่ผมทำใน LlamaIndex คือการพัฒนาเทคโนโลยีของ AI document processing pipeline ให้มีประสิทธิภาพที่ดีขึ้น ไม่ว่าจะเป็นการพัฒนาโมเดลเฉพาะทางภายในองค์กรเพื่อแปลงข้อมูลจาก PDF ออกมาในราคาเสี้ยวเดียวเมื่อเทียบกับการใช้ AI ความสามารถสูงๆ มาอ่านเอกสารโดยตรง, การพัฒนาเทคโนโลยีเฉพาะสำหรับเอกสารแบบเฉพาะทางเช่นการอ่านแบบฟอร์มต่างๆ , และการพัฒนาระบบที่ช่วยให้เลือกใช้โมเดลขนาดเล็กราคาถูกหรือโมเดลขนาดใหญ่ราคาสูงตามความซับซ้อนของเอกสารได้ตามเวลาจริง (realtime) องค์ประกอบเหล่านี้เป็นขีดความสามารถสำคัญของ LlamaIndex ในการแข่งขัน
คู่แข่งหลักของเราคือผู้พัฒนาโมเดลชั้นนำ ที่มี vision-language model (VLM) อย่าง GPT ของ OpenAI, Claude ของ Anthropic และ Gemini ของ Google โมเดลเหล่านี้อ่านเอกสารได้อยู่แล้ว นอกจากนี้ยังมีบริการ OCR จากผู้ให้บริการคลาวด์รายใหญ่อย่าง AWS และ Azure งานนี้ต้องพิจารณาทั้งคุณภาพของผลลัพธ์ ต้นทุน และเวลาประมวลผล LlamaIndex ออกแบบระบบมาสำหรับงานเอกสารโดยเฉพาะ เราจึงปรับสมดุลระหว่างสามด้านนี้ได้ดีกว่าโมเดลอเนกประสงค์ ความต่างนี้เห็นได้ชัดในองค์กรที่ต้องประมวลผลเอกสารจำนวนมากและต้องควบคุมทั้งต้นทุนกับความผิดพลาดของข้อมูล โมเดลอย่าง Claude หรือ GPT ใช้ทำงานได้หลายประเภท แต่ถ้าเรารู้ว่าโจทย์คืองานเอกสาร เราก็ปรับระบบให้เข้ากับงานนั้นและจัดการข้อผิดพลาดที่พบบ่อยได้โดยตรง เครื่องมือเฉพาะทางจึงให้คุณภาพเท่ากันด้วยต้นทุนที่ต่ำกว่ามาก และบ่อยครั้งก็ให้ผลลัพธ์ที่ดีกว่าด้วย ตัวเลขที่ LlamaIndex เผยแพร่คือ LlamaParse มีต้นทุนถูกกว่าการใช้โมเดล VLM จากผู้ให้บริการรายใหญ่ๆ ราว 4 เท่า และแม่นยำกว่า API อื่นในตลาดราว 5 เท่า (note จากผู้สัมภาษณ์ ปัญหา OCR นับเป็นปัญหาที่มีการพัฒนาไปค่อนข้างมาก มีโมเดลใหม่ๆ ออกมาในตลาดต่อเนื่อง รวมถึงเทคโนโลยีจาก LlamaIndex เอง อาจจะต้องวัดระดับความแม่นยำและต้นทุน ถึงความได้เปรียบที่เป็นปัจจุบัน)
ลูกค้าของเรามีทั้งธุรกิจการเงิน บัญชี ประกันภัย กฎหมาย และธุรกิจอื่นที่ต้องประมวลผลเอกสารจำนวนมากด้วยคุณภาพระดับสูงเพื่อนำไปใช้งานโดยตรง ตัวอย่างเช่น KPMG บริษัทบัญชี Big 4 ระดับโลก และบริษัทที่พัฒนา AI เฉพาะทางสำหรับแอปพลิเคชันปลายน้ำ เช่น Lovable ซึ่งเป็นแพลตฟอร์มสร้างแอปพลิเคชันที่มีผู้ใช้ทั่วโลก
ความสำคัญของการทำ RAG ในตอนนี้เป็นอย่างไร ยังเป็น use case สำคัญของ AI อยู่ไหม
RAG (Retrieval-Augmented Generation) ยังมีความสำคัญอย่างมาก โดยเฉพาะในองค์กรขนาดใหญ่ที่ต้องการใช้ AI ที่เข้าใจธุรกิจอย่างแท้จริง ในแง่มุมด้านธุรกิจ โมเดลจะต้องเข้าใจข้อมูลของธุรกิจ (business context) จึงจะใช้งานได้อย่างมีประสิทธิภาพ ข้อมูลเฉพาะขององค์กรโดยทั่วไปจะไม่ได้เผยแพร่บนอินเทอร์เน็ตและไม่ได้อยู่ในชุดข้อมูลที่ใช้เทรนโมเดลใดๆ เราจึงต้องค้นข้อมูลที่เกี่ยวข้องมาให้โมเดลใช้ตอบ ซึ่งก็คือหน้าที่ของ RAG
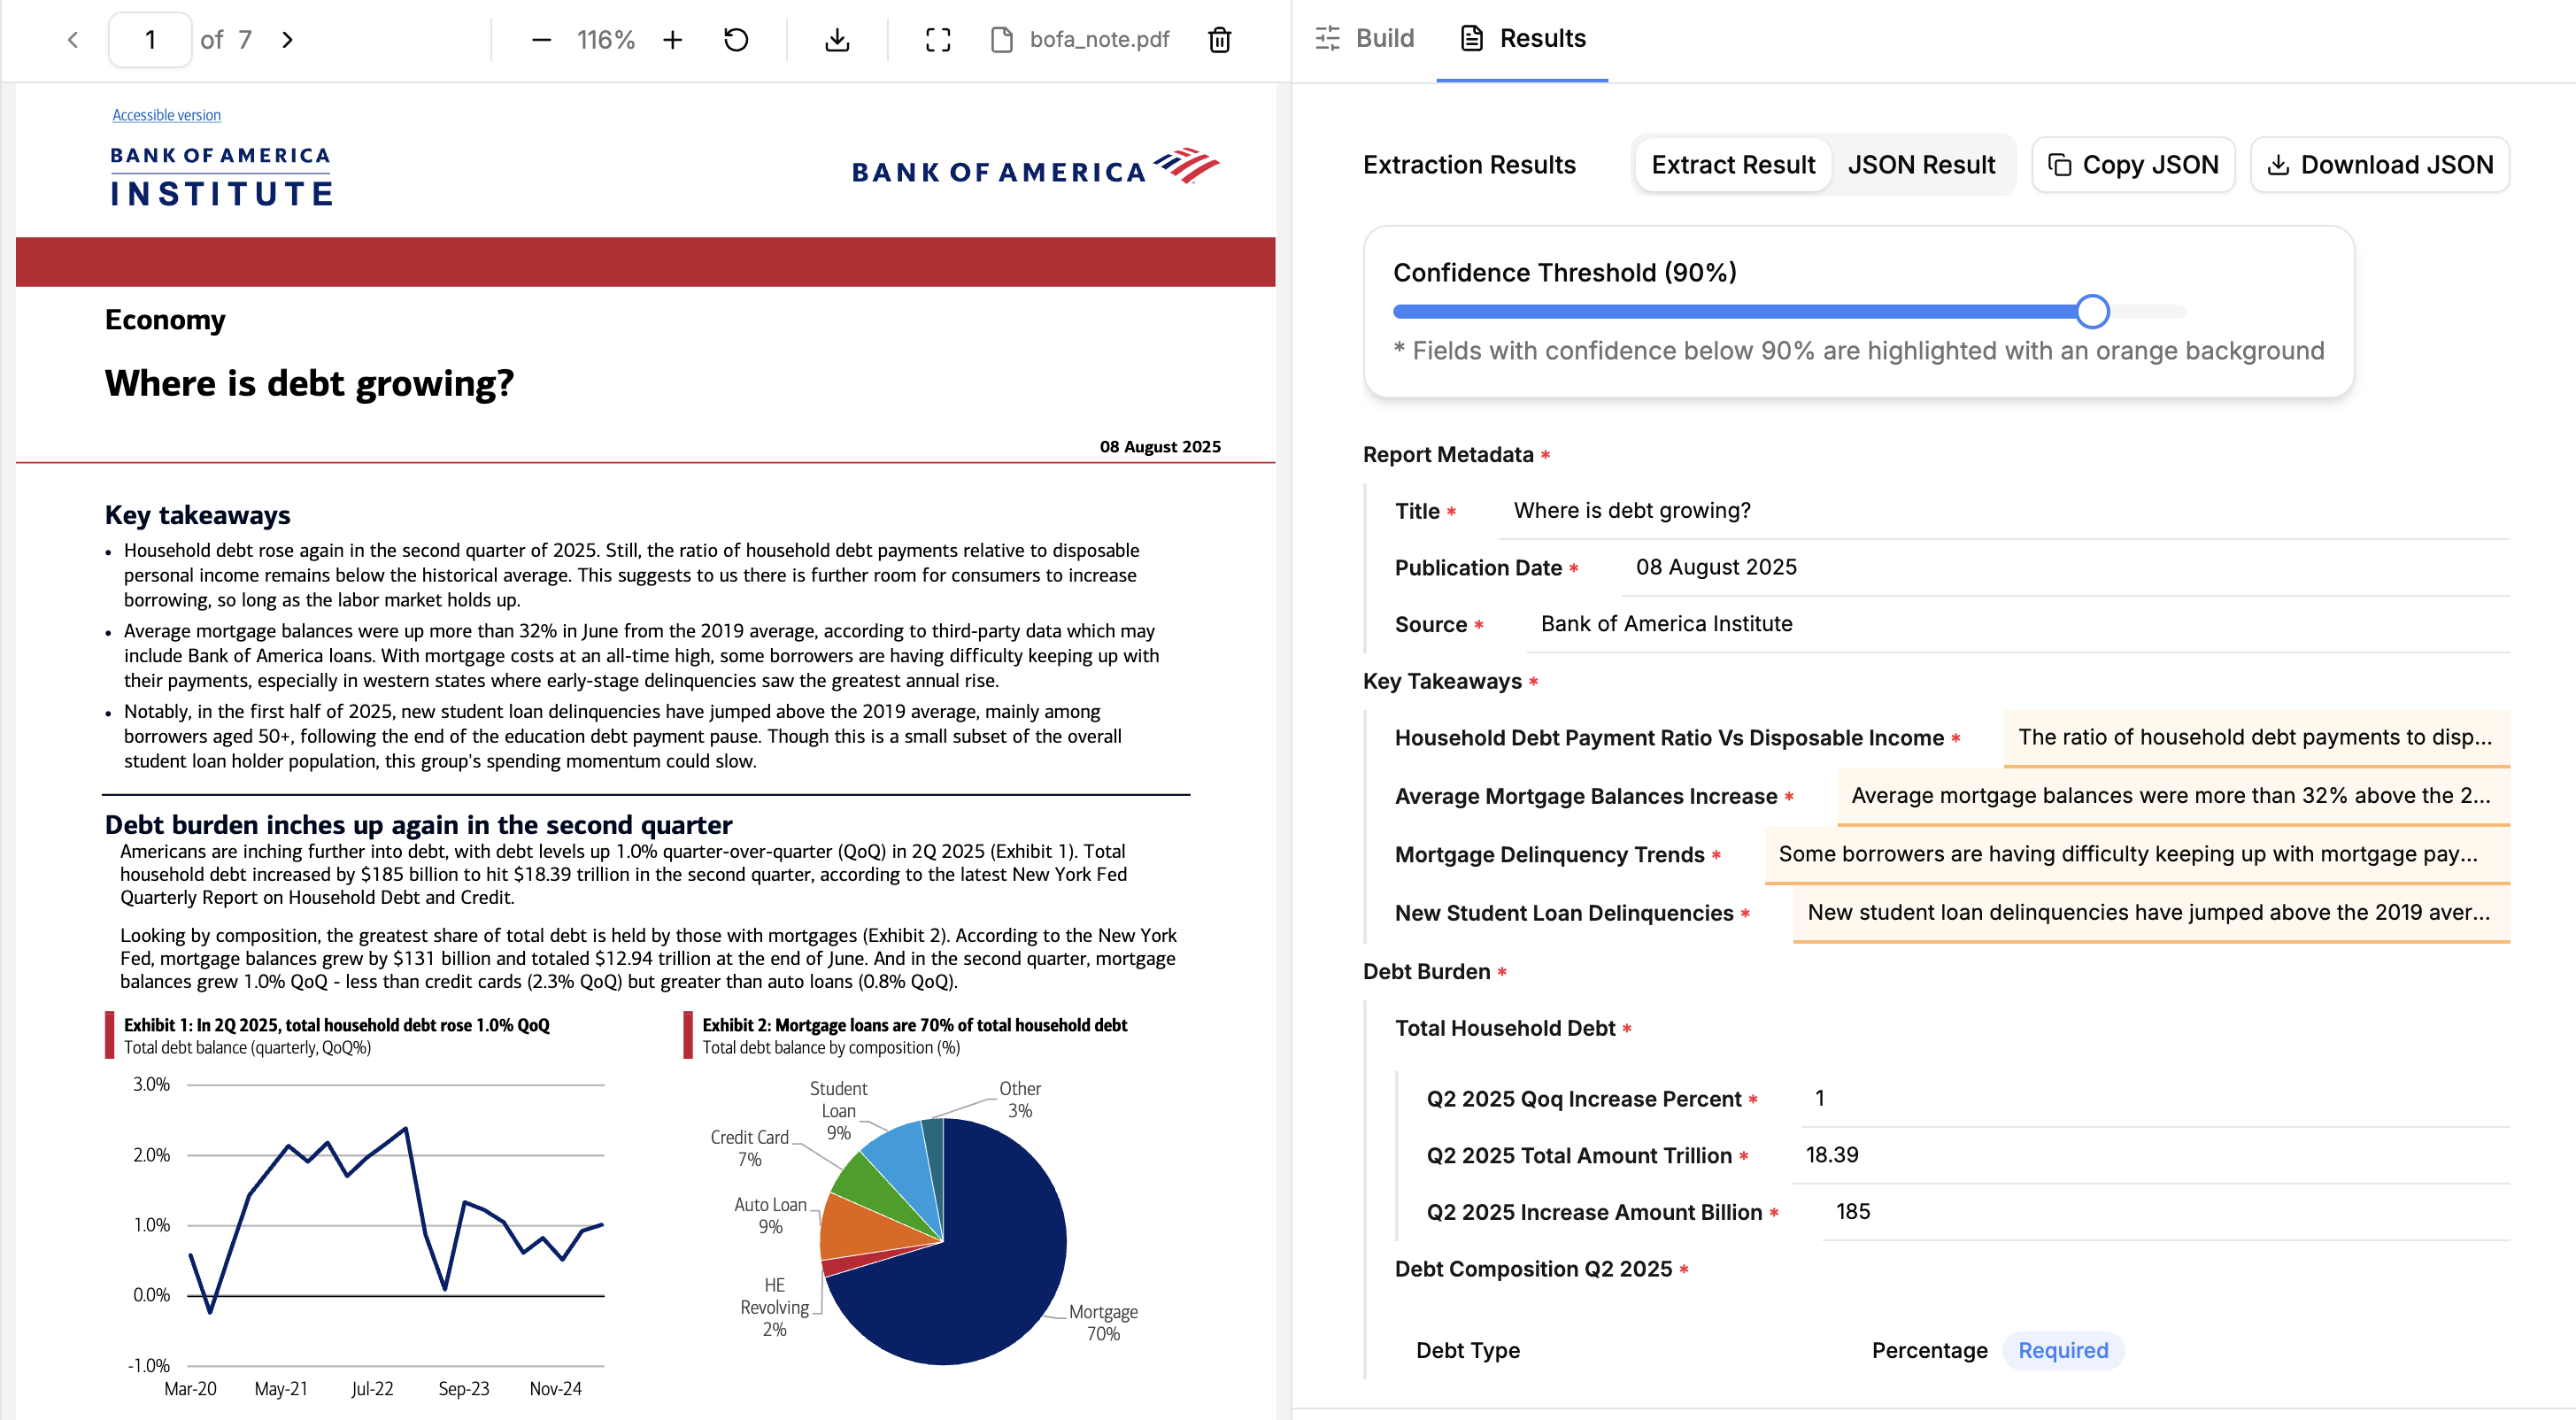
อีกสิ่งที่มีความสำคัญไม่แพ้กันคือความสามารถในการตรวจสอบย้อนกลับ (auditability) ของ AI โดยเฉพาะในการตัดสินใจสำคัญที่ต้องมีการตรวจสอบการทำงานของ AI โดยมนุษย์ องค์กรต้องการให้คำตอบอ้างอิงกลับไปยังไฟล์ต้นทางได้ การทำ retrieval คือการเลือกชุดข้อมูลที่เกี่ยวข้องกับคำถามมากที่สุดมาใช้ตอบ จึงทำให้เราตรวจสอบที่มาของคำตอบที่ AI ให้ได้ง่าย
หากเราไม่ทำ RAG แต่ต้องการให้ AI เข้าใจธุรกิจก็มีวิธีอื่นๆ อยู่ แต่วิธีอื่นจะมีข้อดีและข้อเสียที่แตกต่างกัน วิธีแรกคือการใส่ข้อมูลทั้งหมดลงในพรอมต์โดยตรง ซึ่งทำได้ง่ายและปัจจุบันทำได้ง่ายขึ้นเพราะ context window ของแต่ละโมเดลมีขนาดใหญ่ขึ้นถึงราว 1 ล้านโทเค็นเทียบเท่ากับเอกสารภาษาไทยราวหนึ่งพันหน้า แต่วิธีนี้มีข้อเสียหลายประการ ผู้ใช้ไม่สามารถใส่ข้อมูลขนาดใหญ่ทั้งหมดขององค์กรเข้าไปได้ และข้อมูลในองค์กรมีแนวโน้มเพิ่มขึ้นตลอดในอนาคต การเลือกใส่ข้อมูลที่เกี่ยวข้องสำหรับทุกกรณีการใช้งานก็ทำได้ยากหากไม่มี RAG pipeline และแม้จะทำได้ โมเดลก็อาจหาข้อมูลที่อยู่กลางพรอมต์ที่ยาวมากๆ ไม่เจอ เป็นปัญหาการค้นหาข้อมูลแบบ needle in a haystack นอกเหนือจากนี้ การส่งข้อมูลขนาดใหญ่เข้าไปในโมเดลมีต้นทุนสูง เนื่องจากค่าบริการของโมเดลชั้นนำแบบปิดอย่าง GPT, Claude หรือ Gemini คิดตามโทเค็นยิ่งใช้อินพุตขนาดใหญ่ ราคาต่อการเรียกใช้งานแต่ละครั้งก็ยิ่งสูง และสำคัญที่สุดคือการตรวจสอบแหล่งที่มาของข้อมูลที่ AI ใช้ตอบคำถามจะทำได้ยากกว่า ต่างจาก RAG ที่เรารู้ว่าไฟล์ไหนถูกเลือกใช้งานโดยโมเดล
อีกวิธีคือการเทรนโมเดลด้วยข้อมูลที่บริษัทมีหรือที่เรียกว่า post-training เพื่อให้โมเดลเข้าใจข้อมูลต่างๆ ที่บริษัทมี วิธีนี้มีข้อดีคือโมเดลที่เรานำมาเทรนจะเป็นโมเดลเปิดที่นำมาใช้ได้โดยไม่มีค่าไลเซนส์ ต้นทุนหลักตอนใช้งานคือ GPU ที่ใช้รันโมเดล ซึ่งโดยรวมต้นทุนจะต่ำกว่าการใช้ closed source model อย่าง GPT, Claude หรือ Gemini มาก ข้อเสียคือต้องใช้ความเชี่ยวชาญเฉพาะในการเทรนโมเดลเหล่านี้ ซึ่งมีต้นทุน research and development สูงทั้ง compute ที่ใช้เทรนโมเดลและตัวบุคคลนักวิจัย การอัปเดตโมเดลเมื่อมีข้อมูลใหม่เข้ามาก็ทำได้ยากเพราะต้องเทรนโมเดลใหม่ แตกต่างจากการใช้ RAG ที่เพียงเพิ่มข้อมูลให้ pipeline หาเจอก็เพียงพอ
ความท้าทายของการทำประมวลผลเอกสารภาษาไทย รวมถึงเอกสารที่มีความซับซ้อนสูงเป็นอย่างไร
เอกสารที่มีความซับซ้อนมีความท้าทายหลายประการ ผมขอจำแนกเป็นความซับซ้อนในหน้าเอกสาร และความซับซ้อนในองค์รวมของเอกสาร
ในส่วนของความซับซ้อนภายในหน้าเอกสาร เอกสารที่ซับซ้อนจะมีโครงสร้างที่โมเดล AI อ่านได้ยาก ไม่ว่าจะเป็นความหนาแน่นของข้อมูลต่อพื้นที่กระดาษที่สูง หรือการผสมข้อมูลหลายประเภทเข้าด้วยกัน ทั้งตัวอักษร รูปภาพ และตาราง โมเดลที่ใช้มีสองกลุ่มหลัก กลุ่มแรกคือ vision-language model (VLM) ขนาดใหญ่ที่อ่านเลย์เอาต์และข้อความร่วมกัน อีกกลุ่มคือ Optical Character Recognition (OCR) ที่เน้นอ่านข้อความ ยิ่งเอกสารซับซ้อน VLM ก็ยิ่งมีโอกาสสร้างข้อมูลที่ไม่มีอยู่ในเอกสาร หรือ hallucinate และอาจไม่เข้าใจ reading order คือลำดับก่อนหลังว่าต้องอ่านส่วนไหนในเอกสารก่อน ทำให้ดึงข้อมูลออกมาไม่ถูกต้อง เอกสารซับซ้อนยังใช้ output token มากขึ้น และหลายครั้งต้องใช้ input token เพิ่มด้วย เพราะต้องปรับ prompt ให้ละเอียดขึ้น ส่วน OCR เองก็มีข้อจำกัด เช่น ยังอ่านตัวอักษรที่เล็กมากหรือความละเอียดต่ำอย่างเอกสารเก่าหรือเอกสารสแกนผิดอยู่ ถ้าหน้าหนึ่งมีข้อความแยกอยู่หลายจุด ก็ต้องใช้ทรัพยากรและเวลาประมวลผลมากขึ้น ทั้งต้นทุนและความช้าจะเห็นชัดเมื่อประมวลผลเอกสารจำนวนมาก ตัวผมเองเป็นผู้พัฒนาระบบ document processing ของบริษัท ซึ่งประยุกต์ใช้ทั้ง VLM และ OCR ผสมผสานกัน เพื่อให้ดึงข้อมูลจากเอกสารได้อย่างมีประสิทธิภาพสูงสุด
ในส่วนของความยากในองค์รวม บางกรณีเอกสารแต่ละหน้าไม่ได้ซับซ้อนสูง แต่การดึงข้อมูลของทั้งเอกสารให้ถูกต้องนั้นซับซ้อน ตัวอย่างเช่น ตารางเอกสารทางการเงินความยาวหลายร้อยหน้าที่ต้องอ่านออกมาให้ หัวตารางตรงกันทั้งหมด และไม่มีการทำข้อมูลแถวหรือคอลัมน์ใดตกหล่น ซึ่งข้อผิดพลาดเหล่านี้มักเกิดขึ้นแบบเงียบๆ และตรวจสอบได้ยาก โมเดลต้องอ่านเอกสารหน้านั้นๆ โดยยังคำนึงถึงข้อมูลจากเอกสารในหน้าอื่นๆ และต้องใช้ harness ซึ่งคือทำหน้าที่ควบคุมการทำงานเพิ่มเติมจากโมเดล เพื่อรวมข้อมูลจากแต่ละหน้าเข้าด้วยกันอย่างถูกต้อง
เอกสารที่ซับซ้อนสูงมากบางประเภทต้องมี workflow จำเพาะ ส่วนตัวผมเป็นผู้พัฒนาเทคโนโลยีการอ่านเอกสารเฉพาะทางเช่น แบบฟอร์มต่างๆ ซึ่งเป็นเอกสารที่มีโครงสร้างซับซ้อนกว่า เอกสารข้อความทั่วไปมาก ไม่ว่าจะเป็นส่วนประกอบของฟอร์ม เช่น ช่องให้กาเลือกหรือช่องเติมคำ หลายช่องที่อยู่ใกล้กัน โมเดลต้องเข้าใจว่า ช่องเติมคำนี้มีคำระบุว่าให้เติมอะไร และข้อมูลที่ลูกค้ากรอกคืออะไร, การออกแบบออปเจกต์ให้แสดงข้อมูลในฟอร์มได้หลากหลายรูปแบบ, หรือการอ้างอิง (attribution) ที่ทำให้ผู้ใช้เชื่อมโยงผลลัพธ์ที่ประมวลผลออกมากลับไปที่ช่องกาเลือกขนาดเล็กบนหน้าเอกสารได้ จึงต้องมีโมเดลจำเพาะที่ตรวจจับส่วนประกอบเอกสารเหล่านี้บนฟอร์มได้อย่างแม่นยำ
นอกเหนือจากการอ่านเอกสารให้ถูกต้อง ในหลายกรณีเอกสารที่ซับซ้อนหน้าเดียวอาจแปลงออกมาเป็นข้อความได้หลายแบบที่ถูกต้องเหมือนกัน เราจึงต้องเริ่มจากการกำหนดว่าจะเก็บเนื้อหาและโครงสร้างให้อยู่ในรูปแบบข้อมูลอย่างไร หรือที่เรียกว่า representation ความยากคือการแปลงข้อมูล PDF ที่ซับซ้อน มีทั้งตาราง รูปภาพ และกราฟ ให้อยู่ในรูปแบบข้อความที่สามารถดึงเอา representation ของเอกสารได้ เช่น ตารางที่ซับซ้อนสามารถ represent ใน HTML ได้หลายแบบโดยที่เข้าใจได้เหมือนกัน หรือรูปไอคอนที่อยู่ในเซลล์ตารางก็แปลงเป็นคำพูดได้หลากหลายรูปแบบ พอผลลัพธ์ที่ถูกต้องมีได้หลายแบบ การประเมินผลก็ยากตามไปด้วย เราต้องกำหนดคำตอบอ้างอิงให้ชุดทดสอบหรือทำ label และเขียนเกณฑ์ให้ครอบคลุมว่าผลลัพธ์แบบไหนยอมรับได้ จึงจะวัดความถูกต้องของระบบและลดงานตรวจสอบด้วยคนได้ เอกสารซับซ้อนทำให้ทั้งการสร้าง benchmark dataset และการกำหนดเกณฑ์เหล่านี้ยากขึ้น benchmark ที่ผมออกแบบและใช้ในบริษัทจึงคำนึงถึงจุดนี้เป็นสำคัญ
สำหรับภาษาไทย ความสามารถของโมเดลที่ใช้อ่านเอกสารทั้ง VLM และ OCR ขึ้นอยู่กับคุณภาพและปริมาณข้อมูลที่ใช้เทรน ภาษาไทยมีข้อมูลสำหรับเทรนค่อนข้างน้อยเมื่อเทียบกับภาษาอังกฤษ จัดเป็น low-resource language จึงยังเห็นความต่างของผลลัพธ์ระหว่างสองภาษาในงานเดียวกัน เราจึงต้องทดสอบกับภาษาไทยตั้งแต่ตอนพัฒนาระบบ แต่ชุดข้อมูลทดสอบภาษาไทยที่เหมาะกับงานหาได้ยาก และ benchmark ที่ผู้ขายเผยแพร่ส่วนใหญ่ก็เป็นภาษาอังกฤษ ในทางปฏิบัติจึงมักต้องสร้างขึ้นเองถึงจะวัดได้ว่าระบบมีปัญหาตรงไหน ถ้าต้องทำงานกับเอกสารภาษาไทยที่ซับซ้อน ก็ต้องจัดการปัญหาทั้งสองส่วนนี้ไปพร้อมกัน โดยเลือกขั้นตอนและโมเดลให้เหมาะกับงาน แล้ววัดผลกับชุดเอกสารของตัวเองจริง ๆ